En esta serie de publicaciones de blog, analizaremos algunos de los desafíos técnicos clave que surgen al crear un sistema bancario central en un entorno distribuido. En esta primera entrega, sentamos las bases contextuales explorando algunas características clave de las primeras generaciones de sistemas bancarios centrales. Continuamos examinando una tercera ola de sistemas bancarios que surgió a principios de siglo, la cual intentó resolver los problemas que enfrentaban los bancos, y analizamos por qué les costó tanto consolidarse. Concluimos la exploración presentando algunas características clave del sistema que serían necesarias para permitir que los bancos, muchos de los cuales todavía utilizan sistemas mainframe desarrollados en la década de 1970, migren de sus plataformas obsoletas a una nueva generación de sistemas.
Comenzamos echando un vistazo rápido a cuáles son las capacidades clave de un sistema bancario central, a menudo denominado simplemente "el núcleo" o sistema de registro:
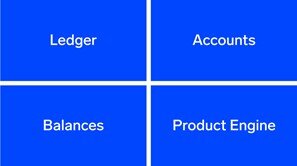
- Libro mayor: el corazón del núcleo, es la lista inmutable de las transacciones que han sido procesadas por el sistema, a menudo considerada como la fuente de verdad para el movimiento de fondos en el banco
- Cuentas: el registro de cuenta central que puede corresponder a una cuenta de cliente, pero que también podría corresponder a una cuenta propiedad del banco o a un registro contable especial, como una cuenta nostro o una cuenta puente. Cada transacción en el libro mayor hace referencia tanto a una cuenta de débito como a una de crédito
- Saldos: el núcleo calcula los saldos de todas sus cuentas. Dependiendo de la complejidad del núcleo, esto puede variar desde un saldo simple para cada cuenta hasta una estructura más compleja que rastrea múltiples dimensiones dentro de cada cuenta, como activos, divisas y fondos reservados
- Motor de productos: un término amplio para englobar cualquier toma de decisiones sobre "productos" que el núcleo pueda realizar en torno a una cuenta. El caso más sencillo es decidir si se permite añadir una transacción determinada al libro mayor, lo que normalmente implicaría una comprobación de saldo. El alcance del motor de productos difiere de un núcleo a otro y puede incluir desde cálculos de intereses hasta el traspaso de fondos entre cuentas para cumplir con reglas de procesamiento complejas.
La terminología suele estar sobrecargada, pero, en términos generales, cuando los bancos hablan del "núcleo", se refieren a estas capacidades centrales clave, y cuando se refieren a un "sistema bancario central", pueden estar refiriéndose de manera más amplia a una pila tecnológica más extensa que podría incluir capacidades adicionales. Las propuestas comerciales de sistemas bancarios centrales "listos para usar" o de "caja negra" a menudo incluyen una mayor parte de esta pila, y el reemplazo de dichos sistemas se encuentra actualmente en el centro de los desafíos informáticos de muchos bancos.
Una nueva generación emergente de sistemas bancarios centrales
Al observar la evolución de los sistemas bancarios centrales a lo largo del tiempo, notamos una tendencia predecible: los sistemas bancarios parecen seguir, lenta pero inexorablemente, los patrones emergentes de la arquitectura de software. Dado que muchos de los sistemas bancarios disponibles hoy en el mercado aún se basan en arquitecturas monolíticas de procesamiento por lotes, es solo cuestión de tiempo hasta que surja una nueva generación de sistemas que adopte la práctica cada vez más consolidada de las arquitecturas de microservicios en la nube, lo que es prácticamente sinónimo de un entorno distribuido.
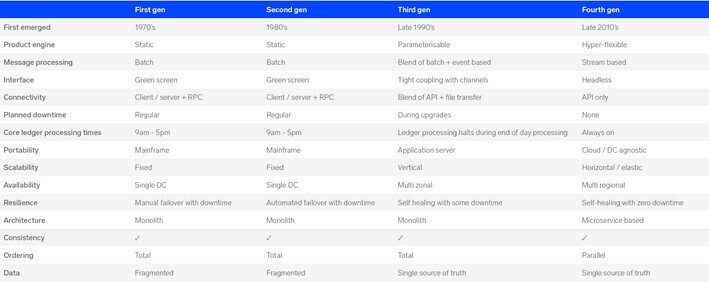
Para entender por qué la transformación bancaria va a la zaga de otros sectores, ayuda analizar sus orígenes. La «primera generación» de sistemas centrales, que surgió alrededor de la década de 1970, se diseñó para emular un modelo bancario que llevaba siglos en funcionamiento. Y tiene sentido: si algo funciona, ¿para qué cambiarlo?
Este modelo suele implicar una serie de sucursales que cierran a las 5 de la tarde, momento en el que se calculan las posiciones del cierre del día y se consolidan en un «libro mayor» centralizado, que actúa como repositorio principal de los datos contables del banco. Cuando aparecieron los sistemas de primera generación, el requisito clave era contar con una red unificada que permitiera a los clientes realizar transacciones en cualquier sucursal. Como esto fue antes de la llegada de una internet pública estable, la comunicación entre servidores era lenta y poco fiable. Los sistemas solían conectarse mediante un modelo cliente-servidor y utilizaban protocolos de confirmación en dos fases para garantizar la entrega de mensajes, lo que aumentaba aún más los costes de comunicación. Para solucionar este problema, los bancos solían alojar todos sus sistemas y datos clave en una única máquina. El resultado fue que estos primeros sistemas bancarios centrales eran de estilo monolítico y estaban diseñados exclusivamente para ejecutarse en costosos mainframes, las únicas máquinas capaces de gestionar el volumen de sesiones cliente-servidor necesarias para atender a todas las sucursales de un banco.
Al llegar la década de 1980, la banca de consumo evolucionó para dejar de centrarse exclusivamente en las sucursales, y los sistemas de primera generación se ampliaron para dar soporte a canales emergentes como los cajeros automáticos y los centros de atención telefónica. Esto impulsó una segunda generación de sistemas capaces de gestionar estos nuevos canales y la creciente demanda de capacidad de servidor; sin embargo, la arquitectura subyacente permaneció prácticamente inalterada.
Los bancos invirtieron enormes cantidades en estos sistemas iniciales, lo que los hizo increíblemente resistentes y capaces de manejar un gran volumen de procesamiento con baja latencia, incluso para los estándares actuales. El hecho de que muchos bancos sigan utilizando estos sistemas hoy en día es prueba de su éxito. Dicho esto, existe un importante inconveniente: estos sistemas son extremadamente costosos de mantener, especialmente porque deben dimensionarse para los picos de procesamiento (típicamente la conciliación de fin de mes), lo que deja una capacidad costosa ociosa durante largos periodos de tiempo.
Aunque estos sistemas anteriores se consideraron exitosos durante mucho tiempo, vemos que los bancos centran cada vez más su atención en la transformación central, lo que sugiere que muchos de ellos operan sobre «plataformas en llamas». El sistema central típico de primera generación se diseñó para satisfacer los productos bancarios de los años 70, pero las necesidades de los reguladores y las demandas de los consumidores han cambiado significativamente desde entonces, y siguen haciéndolo. Un informe de CACI de 2019 estimó que 25 millones de clientes en el Reino Unido utilizan aplicaciones de banca móvil; esta tendencia social por sí sola ha impulsado la necesidad de un cambio continuo y la capacidad de gestionar la naturaleza más volátil y permanente (24/7) de las necesidades de la banca móvil. Desafortunadamente para los bancos que aún dependen de mainframes, no solo son costosos de operar, sino que el coste del cambio también es elevado. Para agravar el problema, los bancos se enfrentan a una presión creciente para reducir costes.
La tercera generación
En respuesta a estos problemas, al acercarse el cambio de siglo empezamos a ver surgir una nueva generación de sistemas bancarios centrales, a veces denominada «tercera generación». Estos sistemas abordaron muchos de los problemas que experimentaban los bancos. Contaban con motores de productos parametrizables, lo que hacía que el cambio fuera más barato y menos arriesgado. Aprovechando la llegada de la banca en línea, estos sistemas solían incluir capacidades de interfaz de usuario avanzadas; sin embargo, dado que a menudo estaban estrechamente vinculados a sus respectivas interfaces, podía resultar difícil combinar esta nueva flexibilidad de formas innovadoras.
Por lo general, estaban escritos en lenguajes de programación más modernos y eran desplegables en servidores de aplicaciones, lo que allanó el camino para que los bancos abandonaran sus costosos mainframes. No obstante, estas aplicaciones solían tener estado y dependían de la gestión de sesiones, lo que dificultaba su escalabilidad de cualquier forma que no fuera vertical.
Aunque esta nueva oleada de sistemas bancarios centrales resolvió varios de los desafíos que enfrentaban los bancos, persistieron algunos puntos críticos. Estos sistemas siguen utilizando en gran medida el procesamiento por lotes y son de estilo monolítico, y dado que ya no estaban vinculados al costoso pero eficaz mainframe, se puede observar que son menos resistentes y eficientes en comparación con sus predecesores. Esto podría explicar por qué la tercera generación tuvo dificultades para consolidarse; aunque ha tenido aceptación en bancos de segundo nivel, no ha logrado penetrar en el mercado de primer nivel de manera significativa.
Esto supuso un problema para los bancos más grandes, que tuvieron dificultades para avanzar en sus proyectos de transformación central. Los bancos que no querían arriesgarse a abandonar sus mainframes encontraron formas ingeniosas de sortear el problema del sistema central heredado:
- «Vaciar el núcleo» se está convirtiendo rápidamente en la estrategia de facto, y consiste en extraer el motor de productos, junto con otras capacidades clave, fuera del sistema central. El resultado es que los bancos pueden confiar en productos más modernos para resolver algunas de las deficiencias del sistema heredado, pero la desventaja es que aumenta la complejidad operativa y el desafío de integración. Además, la proliferación de estos sistemas tácticos provoca silos de datos que generan costes adicionales, como preocupaciones sobre el dominio de los datos, así como problemas de procedencia, conciliación y certificación de datos.
- Desplegar «adaptadores» (shims) de API en el mainframe. Algunos bancos han optado por instalar software directamente en el mainframe que permite exponer datos, anteriormente difíciles de extraer, a través de APIs modernas. La llegada de la normativa PSD2 y la banca abierta dio lugar a varias implementaciones destacadas de este enfoque; sin embargo, existe un peligroso compromiso: dado que los sistemas subyacentes carecen de las propiedades de escalabilidad elástica para manejar los volúmenes de carga de trabajo volátiles resultantes, los bancos podrían provocar involuntariamente un ataque DDoS en sus propios sistemas centrales.
El resultado es que los bancos más grandes han logrado sobrevivir modernizando la pila tecnológica alrededor de un núcleo heredado. Aunque esto puede funcionar durante un tiempo, solo hemos retrasado lo inevitable: un banco no puede sobrevivir indefinidamente con un núcleo moribundo. Cuanto más se extrae del núcleo, más complejidad se traslada al nivel intermedio, lo que provoca silos de datos y aumenta la fragilidad general del sistema.
Las grietas comenzaron a aparecer tras la crisis financiera mundial, cuando los bancos se enfrentaron al difícil desafío de reducir los costes de su infraestructura informática para mantener productos bancarios competitivos en el mercado, al tiempo que debían adaptarse a las cambiantes expectativas de los consumidores y a las demandas cada vez más estrictas de los reguladores. Un ejemplo notable de esto último es la introducción de la tercera versión del acuerdo de Basilea, Basilea III, que impone a los bancos exigencias crecientes para adaptar sus sistemas centrales de formas que parecen chocar directamente con el modelo tradicional de procesamiento por lotes al final del día, como el requisito de gestión de liquidez intradía.
De repente, los bancos se encontraron ante dos desafíos clave que parecían entrar en conflicto. Para reducir los costes de su infraestructura, necesitaban deshacerse de sus mainframes y operar con una infraestructura más ligera, lo que reduciría el techo de cristal sobre la potencia de procesamiento del sistema. Al mismo tiempo, para adaptarse a los cambios regulatorios, debían aumentar la frecuencia de sus trabajos de procesamiento por lotes, lo que requeriría más potencia de procesamiento.
Para agravar el problema, los sistemas bancarios centrales suelen estar diseñados de tal manera que solo pueden ejecutarse cuando el libro mayor central está cerrado. Hay varias razones por las que esto tiene sentido, como evitar la contención de recursos entre el procesamiento por lotes y el tráfico en línea, así como garantizar que las transformaciones se ejecuten sobre un conjunto de datos estable (estático). Dado que nuestro modelo tradicional de banca solo estaba abierto al público de 9 a 17 horas, cerrar el núcleo tenía todo el sentido para los sistemas de primera generación. A medida que la demanda de los consumidores cambió y la banca 24/7 se convirtió en la norma, los sistemas de tercera generación generalmente se adaptaron acortando el tiempo de cierre del núcleo y permitiendo que el sistema funcionara en modo de «espera» (stand-in), de modo que los pagos se almacenan temporalmente mientras el banco realiza la transición del proceso de fin de día. Esto conlleva sus propias complicaciones, ya que añadimos una complejidad considerable al sistema: terminamos construyendo un banco dentro de otro banco para gestionar el modo de espera y tenemos que hacer malabarismos para integrar el libro mayor de espera al inicio del siguiente día bancario. El resultado neto es que ejecutar las mismas operaciones basadas en lotes durante todo el día bancario a menudo no es viable.
Para resumir nuestra exploración sobre los desafíos que enfrentan los bancos con sus sistemas centrales heredados, nos enfocamos en una limitación común: dado que son inherentemente monolíticos, solo pueden escalarse en una dimensión, la vertical. Esto inhibe fundamentalmente la agilidad de los bancos, tanto en términos de adaptación al cambio como en su capacidad para reducir costos.
Afortunadamente para los bancos, hay esperanza. Estamos tratando con un problema común que existe en muchos ámbitos, tanto dentro como fuera de los servicios financieros, un problema que comienza a abordarse con una arquitectura basada en microservicios. En dicha arquitectura, cada parte del sistema puede escalarse dinámica y elásticamente para adaptarse a cualquier necesidad de procesamiento, manteniendo las partes no afectadas del sistema con una escala menor, lo que garantiza que la huella general (y, por ende, el costo) del sistema se mantenga baja. Como resultado, una arquitectura basada en microservicios allana el camino para un sistema bancario central escalable y enfocado en tiempo real.
Entonces, ¿por qué los sistemas centrales de tercera generación simplemente no refactorizan sus sistemas existentes, dividiendo el monolito en una arquitectura basada en microservicios?
Fragmentar el monolito bancario central
Para responder a esta pregunta, ayuda observar algunos de los beneficios clave de la arquitectura monolítica. Un monolito tiene un único reloj físico y, por lo tanto, un acceso sencillo a un ordenamiento global (total) único. Tener un ordenamiento total hace que garantizar la precisión en cualquier solicitud sea relativamente directo. A medida que el monolito se divide, perdemos el reloj común y, como resultado, el ordenamiento. Esto significa que la precisión se vuelve difícil de mantener. Es posible que la lógica de la aplicación deba refactorizarse considerablemente para manejar condiciones de carrera y cuellos de botella causados por la latencia de la red. A menudo, sin refactorizar el sistema desde cero, garantizar que los eventos relacionados causalmente se procesen en el orden correcto sin sacrificar significativamente el rendimiento del sistema puede convertirse en un problema intratable. Además, es fácil caer en la trampa de crear simplemente un "monolito distribuido" y, como resultado, verse lastrado por los peores atributos de ambos paradigmas.
Sobre la nube frente a la nube como prioridad
A medida que los sistemas de tercera generación luchaban por fragmentar sus monolitos y enfrentaban una presión creciente del mercado para "moverse a la nube", los proveedores a menudo emplearon una estrategia de "lift and shift", tomando su servidor de aplicaciones monolítico, contenedorizándolo e implementándolo en la nube. Aunque esto califica técnicamente como una estrategia de nube, podríamos argumentar que no es muy efectiva; no hemos aprovechado ninguno de los beneficios de estar en la nube, notablemente la escalabilidad elástica. Básicamente, estamos tratando con el mismo monolito, ¡pero ahora en un centro de datos más costoso!
Basándonos en esto, podría parecer que las condiciones están dadas para una nueva ola, una cuarta generación de sistemas bancarios centrales construidos desde cero que adopten la escalabilidad elástica de la nube mediante el aprovechamiento de una arquitectura basada en microservicios.
¿Por qué no ha sucedido esto ya?
Existen varias razones que podrían explicar por qué apenas estamos comenzando a ver surgir una nueva generación de sistemas bancarios centrales:
- Los bancos generalmente se mueven con lentitud. Tienen una naturaleza históricamente cautelosa, lo cual es comprensible dada la criticidad de los datos que gestionan. Por lo general, existe mucha gobernanza en torno al cambio de TI para mitigar el riesgo, con el efecto secundario involuntario de ralentizar las cosas.
- Un ecosistema y una cultura de desarrollo efectivos pueden tardar años en crecer orgánicamente, lo que significa que los bancos se encuentran ante un dilema, ya que habilidades clave como Cobol están desapareciendo del mercado, y trasplantar un nuevo equipo interno enfocado en un ecosistema de desarrollo más moderno puede ser un esfuerzo a largo plazo.
- Hasta hace poco, la nube generalmente no contaba con la confianza de los reguladores, lo que impedía que los bancos aprovecharan la infraestructura en la nube para reducir la barrera de entrada a una infraestructura escalable.
Sin embargo, argumentamos que una razón clave es simplemente que construir un banco en un entorno distribuido es difícil.
Cuando tratamos con una arquitectura basada en microservicios, estamos tratando inherentemente con un entorno distribuido. Esto significa que trabajamos con un sistema que debe lidiar con una amplia gama de latencias: cualquier recorrido a través del sistema probablemente pasará la mayor parte de su tiempo en la red entre servicios. Como ilustra Gregg (2013), si un ciclo de CPU tomara un segundo, un salto de red de San Francisco a Nueva York tomaría 4 años. También significa que estamos a merced de las "falacias de la computación distribuida". Además de no tener un reloj común como exploramos anteriormente, nos enfrentamos a una red poco confiable en la que las solicitudes pueden retrasarse indefinidamente o perderse por completo.
En muchas otras industrias podríamos estar bien con perder algún mensaje ocasional o lidiar con alguna condición de carrera, sin embargo, en la banca, la precisión es la prioridad número uno. No podemos perder ni un solo mensaje, ya que esto podría resultar en cualquier cosa, desde que el saldo de un cliente pierda la sincronización hasta que grandes sumas de dinero se evaporen en el éter.
Dado que garantizar la precisión en un sistema distribuido es un problema difícil, construir un sistema bancario central basado en microservicios es un desafío.
¿Cómo es, entonces, la «cuarta generación» de sistemas bancarios centrales?
La próxima generación de sistemas bancarios centrales debe construirse con un enfoque que priorice la nube. La escalabilidad elástica debe estar integrada desde el diseño, al igual que los mecanismos para garantizar la precisión y una configurabilidad hiperflexible. Estos sistemas deben ser capaces tanto de escalar horizontalmente para gestionar un volumen masivo de transacciones como de reducirse para funcionar con una infraestructura mínima en periodos de baja actividad. Deben operar en tiempo real, sin pérdida de datos y sin tiempos de inactividad planificados; y, lo que es más importante: el núcleo nunca debe detenerse.
El «núcleo sin cabeza» (headless core)
Partiendo de esto, es importante que la próxima generación de sistemas bancarios tenga un alcance conservador. Los sistemas mainframe sufren porque su núcleo ha sido «vaciado», lo que los vuelve demasiado limitados. Los sistemas de tercera generación, por su parte, sufren por estar demasiado acoplados a sus interfaces, convirtiéndose en una caja negra difícil de modificar. Un término emergente que los bancos están utilizando para describir sus necesidades de transformación es el «núcleo sin cabeza» (headless core).
Para ayudar a visualizar cómo debería ser un sistema de cuarta generación, analicemos algunas capacidades típicas de los sistemas de la generación anterior:
¿Por qué ahora?
Hasta hace poco, la arquitectura de nube y microservicios era considerada «de vanguardia». Esto está cambiando rápidamente a medida que dicha vanguardia madura y se convierte en una práctica aceptada. Los proveedores de nube trabajan ahora en estrecha colaboración con los reguladores y están reforzando sus infraestructuras a medida que las redes se vuelven más rápidas y fiables. Muchos bancos ya han desplegado sistemas de producción en entornos de nube. Las organizaciones que dominan el sector de los mainframes se están dando cuenta de esto, como demuestra el reciente anuncio de IBM sobre el lanzamiento de la «primera nube pública del mundo preparada para servicios financieros». Están surgiendo herramientas y marcos de trabajo que llevan el aspecto, antes teórico, de la computación distribuida a la práctica común, como Kubernetes, Istio y Kafka. Sumado a esto, la creciente popularidad de las bases de datos NewSQL, como Google Spanner y CockroachDB —que generalmente utilizan consistencia basada en quórum para que las escrituras puedan dirigirse a cualquier nodo—, significa que ahora la base de datos puede escalar junto con la aplicación, allanando el camino para una verdadera escalabilidad lineal. El resultado acumulado es que, sin duda, nos encontramos en el punto de inflexión de la emergente cuarta generación de sistemas bancarios centrales, que responde a las necesidades desde los bancos comunitarios más pequeños hasta los bancos globales de nivel 1 más grandes.
Vault Core: una plataforma bancaria central de cuarta generación
En Thought Machine, cuando nos embarcamos en nuestro viaje para crear Vault Core, vimos tanto el desafío como la oportunidad. Diseñamos cuidadosamente un sistema desde cero capaz de operar de manera eficiente en un entorno distribuido sin sacrificar la precisión ni detener el núcleo en ningún momento. Para lograrlo, entendimos que era fundamental empezar y seguir siendo una organización centrada en la ingeniería y el producto.
Diseñamos Vault Core para gestionar un alto rendimiento con latencias razonables, garantizando al mismo tiempo la ausencia de pérdida de datos. Encontrar el equilibrio adecuado entre las características del sistema es clave, como cualquier ingeniero de sistemas distribuidos le dirá: es un juego de compensaciones. Cada decisión de diseño implica sacrificar una serie de atributos clave del sistema, como el rendimiento, la latencia, la disponibilidad y la durabilidad; las leyes de la física nos dicen que no podemos tenerlo todo. Vault elige cuidadosamente las compensaciones adecuadas en los lugares adecuados.
Con esto concluye la primera publicación de esta serie. A continuación, nos centraremos en varios análisis técnicos profundos sobre algunos de los patrones arquitectónicos que utilizamos para construir Vault Core. Exploraremos cómo el sistema en su conjunto puede considerarse «holísticamente consistente», ya que nos apoyamos en la consistencia eventual cuando es posible, y aseguramos la consistencia fuerte cuando es necesaria. Analizaremos cómo permitimos que el sistema escale apoyándonos en patrones establecidos como la arquitectura «shared nothing», el procesamiento asíncrono/basado en eventos y la contrapresión selectiva. Exploraremos cómo se mantiene la precisión mediante enfoques como la entrega «al menos una vez» con idempotencia, bitemporalidad de recursos y bloqueo optimista. En la próxima entrada del blog de esta serie, profundizaremos en cómo utilizamos relojes vectoriales y bloqueo optimista para escalar nuestra canalización de procesamiento de transacciones central.
———
Obtenga más información sobre Vault Core ahora.
Referencias:
Informe sobre el crecimiento de la banca digital, CACI: https://pages.caci.co.uk/rs/752-EBZ-498/images/caci-future-growth-digital-banking-report-2019.pdf
Gregg, Brendan. 2013: Rendimiento de sistemas: empresa y nube
Nube para servicios financieros de IBM: https://newsroom.ibm.com/2019-11-06-IBM-Developing-Worlds-First-Financial-Services-Ready-Public-Cloud-Bank-of-America-Joins-as-First-Collaborator