In dieser Blogserie beleuchten wir einige der zentralen technischen Herausforderungen bei der Entwicklung eines Kernbankensystems in einer verteilten Umgebung. Im ersten Beitrag legen wir den kontextuellen Grundstein, indem wir die wesentlichen Merkmale früherer Generationen von Kernbankensystemen untersuchen. Wir betrachten anschließend die dritte Welle von Bankensystemen, die um die Jahrhundertwende aufkam, um die damaligen Probleme der Banken zu lösen, und analysieren, warum diese sich nur schwer durchsetzen konnten. Zum Abschluss stellen wir wichtige Systemeigenschaften vor, die Banken – von denen viele noch immer auf Mainframe-Systemen aus den 1970er Jahren basieren – den Umstieg von ihren veralteten Plattformen auf eine neue Systemgeneration ermöglichen würden.
Zunächst werfen wir einen kurzen Blick auf die Kernfunktionen eines Kernbankensystems, das oft einfach als „der Kern“ oder System of Record bezeichnet wird:
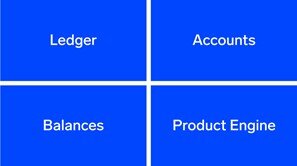
- Hauptbuch: Das Herzstück des Kerns. Es ist die unveränderliche Liste aller vom Kern verarbeiteten Transaktionen und gilt oft als die Quelle der Wahrheit für den Geldfluss innerhalb der Bank.
- Konten: Der zentrale Kontendatensatz, der einem Kundenkonto zugeordnet sein kann, aber ebenso einem bankeigenen Konto oder einem speziellen Buchungskonto wie einem Nostro- oder Verrechnungskonto entsprechen kann. Jede Transaktion im Hauptbuch verweist sowohl auf ein Soll- als auch auf ein Habenkonto.
- Salden: Der Kern berechnet die Salden über alle Konten hinweg. Je nach Komplexität des Systems reicht dies von einem einfachen Saldo pro Konto bis hin zu einer komplexeren Struktur, die mehrere Dimensionen innerhalb eines Kontos nachverfolgt, wie etwa Vermögenswerte, Währungen und zweckgebundene Gelder.
- Produkt-Engine: Ein weit gefasster Begriff für alle produktbezogenen Entscheidungen, die der Kern in Bezug auf ein Konto trifft. Im einfachsten Fall geht es darum, zu prüfen, ob eine Transaktion in das Hauptbuch aufgenommen werden darf, was in der Regel eine Saldenprüfung beinhaltet. Der Funktionsumfang der Produkt-Engine variiert von System zu System und kann alles von Zinsberechnungen bis hin zum automatischen Ausgleich von Konten gemäß komplexer Verarbeitungsregeln umfassen.
Die Terminologie ist oft überladen, aber im Allgemeinen beziehen sich Banken mit dem Begriff „Kern“ auf diese zentralen Funktionen. Wenn sie von einem „Kernbankensystem“ sprechen, meinen sie oft einen breiteren Stack, der zusätzliche Funktionen enthalten kann. Kommerzielle „Bank-in-a-Box“- oder „Black-Box“-Lösungen umfassen häufig einen größeren Teil dieses Stacks, und der Austausch solcher Systeme stellt heute eine der größten IT-Herausforderungen für viele Banken dar.
Eine aufkommende neue Generation von Kernbankensystemen
Betrachtet man die Entwicklung von Kernbankensystemen im Zeitverlauf, zeigt sich ein wenig überraschender Trend: Bankensysteme folgen langsam, aber sicher den aufkommenden Mustern der Softwarearchitektur. Da viele der heute auf dem Markt erhältlichen Bankensysteme noch immer auf monolithischen, stapelverarbeitungsorientierten Architekturen basieren, ist es nur eine Frage der Zeit, bis sich eine neue Systemgeneration durchsetzt, die auf die zunehmend etablierte Praxis cloudbasierter Microservice-Architekturen setzt – was im Wesentlichen einer verteilten Umgebung gleichkommt.
Um zu verstehen, warum die Transformation im Bankwesen hinter anderen Branchen zurückbleibt, hilft ein Blick auf ihre Anfänge. Die „erste Generation“ der Kernsysteme, die um die 1970er Jahre aufkam, wurde entwickelt, um ein Bankmodell zu emulieren, das bereits seit Jahrhunderten bestand – was durchaus Sinn ergibt: Warum etwas ändern, das funktioniert?
Dieses Modell umfasst typischerweise eine Reihe von Filialen, die um 17 Uhr schließen, woraufhin die Tagesendbestände berechnet und in einem zentralen Hauptbuch zusammengefasst werden, das als zentrales Repository für die Buchhaltungsdaten der Bank dient. Als die Systeme der ersten Generation aufkamen, bestand die zentrale Anforderung darin, ein einheitliches Netzwerk zu schaffen, das es Kunden ermöglichte, in jeder beliebigen Filiale Transaktionen durchzuführen. Da dies noch vor der Ära eines stabilen öffentlichen Internets geschah, war die Serverkommunikation langsam und unzuverlässig. Die Systeme kommunizierten meist über ein Client-Server-Modell und nutzten Zwei-Phasen-Commit-Protokolle zur Sicherstellung der Nachrichtenübermittlung, was die Kommunikationskosten weiter in die Höhe trieb. Um dieses Problem zu umgehen, platzierten Banken ihre wichtigsten Systeme und Daten in der Regel auf einer einzigen Maschine. Das Ergebnis war, dass diese frühen Kernbankensysteme monolithisch aufgebaut und ausschließlich für den Betrieb auf teuren Mainframes konzipiert waren – den einzigen Maschinen, die in der Lage waren, die für die Bedienung aller Filialen einer Bank erforderliche Anzahl an Client-Server-Sitzungen zu bewältigen.
In den 1980er Jahren entwickelte sich das Privatkundengeschäft weg von der reinen Filialzentrierung. Die Systeme der ersten Generation wurden erweitert, um neue Kanäle wie Geldautomaten und Callcenter zu unterstützen. Dies beflügelte eine zweite Systemgeneration, die diese neueren Kanäle und den gestiegenen Bedarf an Serverkapazität bewältigen konnte, während die zugrunde liegende Architektur weitgehend unverändert blieb.
Banken investierten enorme Summen in diese frühen Systeme, was sie unglaublich robust machte und ihnen ermöglichte, selbst nach heutigen Maßstäben enorme Durchsatzraten bei geringen Latenzzeiten zu bewältigen. Die Tatsache, dass viele Banken diese Systeme noch heute betreiben, zeugt von ihrem Erfolg. Allerdings gibt es einen wichtigen Kompromiss: Diese Systeme sind im Betrieb extrem teuer, insbesondere da sie auf Spitzenlasten ausgelegt sein müssen – typischerweise den Monatsabschluss –, wodurch teure Kapazitäten über lange Zeiträume ungenutzt bleiben.
Während diese frühen Systeme lange Zeit als erfolgreich galten, verlagern Banken ihren Fokus zunehmend auf die Kerntransformation, was darauf hindeutet, dass viele dieser Institute auf „brennenden Plattformen“ operieren. Der typische Kern der ersten Generation wurde für Bankprodukte der 70er Jahre geschrieben; die Anforderungen der Regulierungsbehörden und Kunden haben sich seitdem jedoch grundlegend gewandelt und tun dies weiterhin. Ein Bericht von CACI aus dem Jahr 2019 schätzte, dass 25 Millionen Kunden in Großbritannien Mobile-Banking-Apps nutzen. Allein dieser gesellschaftliche Trend hat den Bedarf an kontinuierlicher Veränderung und die Notwendigkeit, die volatileren und rund um die Uhr verfügbaren Anforderungen des Mobile Bankings zu erfüllen, vorangetrieben. Für Banken, die noch immer an Mainframes gebunden sind, ist dies fatal: Sie sind nicht nur teuer im Betrieb, sondern auch die Kosten für Änderungen sind hoch. Erschwerend kommt hinzu, dass Banken unter wachsendem Kostendruck stehen.
Die dritte Generation
Als Reaktion auf diese Schwachstellen begannen wir um die Jahrhundertwende, eine neue Generation von Kernbankensystemen zu sehen, die manchmal als „dritte Generation“ bezeichnet wird. Diese Systeme adressierten viele der Probleme, mit denen Banken zu kämpfen hatten. Sie verfügten über parametrisierbare Produkt-Engines, was Änderungen kostengünstiger und weniger riskant machte. Auf der Welle des aufkommenden Online-Bankings boten diese Systeme oft umfangreiche Benutzeroberflächen. Da sie jedoch häufig eng mit ihren jeweiligen Oberflächen gekoppelt waren, war es schwierig, diese neu gewonnene Flexibilität auf innovative Weise zu nutzen.
Sie wurden in der Regel in moderneren Programmiersprachen geschrieben und konnten auf Anwendungsservern bereitgestellt werden, was den Banken den Weg ebnete, sich von ihren teuren Mainframes zu lösen. Diese Anwendungen waren jedoch meist zustandsbehaftet und auf Sitzungsmanagement angewiesen, was eine Skalierung nur vertikal ermöglichte.
Während diese neue Welle von Kernbankensystemen eine Reihe von Herausforderungen löste, blieben einige Kernprobleme bestehen. Diese Systeme nutzen nach wie vor weitgehend stapelverarbeitungsbasierte Prozesse und sind monolithisch aufgebaut. Da sie nicht mehr an den teuren, aber effektiven Mainframe gebunden waren, kann man sogar beobachten, dass sie weniger robust und leistungsfähig sind als ihre Vorgänger. Dies könnte erklären, warum die dritte Generation Schwierigkeiten hatte, sich durchzusetzen: Während es bei Banken der zweiten Ebene eine gewisse Akzeptanz gab, gelang es ihnen nicht, den Markt der führenden Banken (Tier-1) nennenswert zu durchdringen.
Dies stellte die größeren Banken vor ein Problem, da sie bei ihren Kerntransformationsprojekten nur schwer vorankamen. Banken, die das Risiko eines Abschieds vom Mainframe scheuten, fanden stattdessen erfinderische Wege, um das Problem des Legacy-Kerns zu umgehen:
- „Hollow out the core“ (den Kern aushöhlen) entwickelt sich schnell zur De-facto-Strategie und beinhaltet, die Produkt-Engine sowie andere wichtige Funktionen aus dem Kern herauszulösen. Das Ergebnis ist, dass Banken modernere Produkte nutzen können, um einige der Mängel des Legacy-Kerns zu beheben. Der Nachteil ist jedoch eine erhöhte betriebliche Komplexität und eine größere Integrationsherausforderung. Zudem führt die Verbreitung dieser taktischen Systeme zu Datensilos, die zusätzlichen Aufwand verursachen, etwa bei der Datenhoheit sowie bei Fragen der Datenherkunft, Abstimmung und Validierung.
- Bereitstellung von API-„Shims“ auf dem Mainframe. Einige Banken sind dazu übergegangen, Software direkt auf dem Mainframe zu installieren, die zuvor schwer zugängliche Daten über moderne APIs verfügbar macht. Das Aufkommen von PSD2 und Open Banking führte zu einer Reihe prominenter Implementierungen dieses Ansatzes. Es gibt jedoch einen gefährlichen Kompromiss: Da den zugrunde liegenden Systemen die elastischen Skalierungseigenschaften fehlen, um die resultierenden volatilen Arbeitslasten zu bewältigen, könnten Banken unbeabsichtigt einen DDoS-Angriff auf ihre eigenen Kernsysteme auslösen.
Das Ergebnis ist, dass die größeren Banken durch die Modernisierung des Stacks um einen Legacy-Kern herum überleben konnten. Während dies eine Zeit lang funktionieren mag, haben wir das Unvermeidliche nur hinausgezögert: Eine Bank kann nicht ewig mit einem sterbenden Kern überleben. Je mehr aus dem Kern herausgelöst wird, desto mehr Komplexität verlagert sich in die mittlere Ebene, was Datensilos verursacht und die allgemeine Systemanfälligkeit erhöht.
Die Risse zeigten sich nach der globalen Finanzkrise, als die Banken vor der schwierigen Herausforderung standen, sowohl die Kosten ihrer IT-Infrastruktur zu senken, um wettbewerbsfähige Bankprodukte anbieten zu können, als auch sich an veränderte Kundenerwartungen und immer strengere regulatorische Anforderungen anzupassen. Ein bemerkenswertes Beispiel für Letzteres ist die Einführung von Basel III, das Banken zunehmend dazu verpflichtet, ihre Kernsysteme auf eine Weise anzupassen, die direkt mit dem traditionellen Modell der stapelbasierten Tagesendverarbeitung zu kollidieren scheint, wie etwa durch die Anforderung eines untertägigen Liquiditätsmanagements.
Plötzlich sahen sich die Banken mit zwei zentralen Herausforderungen konfrontiert, die im Widerspruch zueinander zu stehen schienen. Um die Kosten ihrer Infrastruktur zu senken, mussten sie ihre Mainframes loswerden und auf einer schlankeren Infrastruktur laufen, was jedoch die Obergrenze für die Rechenleistung im System senkte. Gleichzeitig mussten sie zur Anpassung an regulatorische Änderungen die Frequenz ihrer Stapelverarbeitungsaufträge erhöhen, was wiederum mehr Rechenleistung erforderte.
Erschwerend kommt hinzu, dass Kernbankensysteme oft so konzipiert sind, dass sie nur laufen können, wenn das Hauptbuch geschlossen ist. Es gibt eine Reihe von Gründen, warum dies sinnvoll ist, etwa um Ressourcenkonflikte zwischen Stapelverarbeitung und Online-Verkehr zu vermeiden sowie um sicherzustellen, dass Transformationen auf einem stabilen (statischen) Datensatz ausgeführt werden. Da unser traditionelles Bankmodell nur von 9 bis 17 Uhr geöffnet war, ergab das Schließen des Kerns für Systeme der ersten Generation absolut Sinn. Mit dem Wandel der Kundennachfrage und dem Standard des 24/7-Bankings passten sich Systeme der dritten Generation im Allgemeinen an, indem sie die Schließzeiten des Kerns verkürzten und die Möglichkeit boten, im „Stand-in“-Modus zu arbeiten, sodass Zahlungen gepuffert werden, während die Bank den Tagesabschluss vollzieht. Dies bringt eigene Komplikationen mit sich: Wir fügen dem System erhebliche Komplexität hinzu, bauen eine Bank innerhalb der Bank, um den Stand-in-Betrieb zu bewältigen, und müssen Hürden überwinden, um das Stand-in-Hauptbuch zu Beginn des nächsten Bankarbeitstages zu integrieren. Das Endergebnis ist, dass der Betrieb derselben stapelbasierten Vorgänge während des gesamten Bankarbeitstages oft nicht praktikabel ist.
Zusammenfassend lässt sich sagen, dass die Herausforderungen, vor denen Banken bei ihren bestehenden Kernsystemen stehen, auf eine gemeinsame Einschränkung zurückzuführen sind: Da diese Systeme von Natur aus monolithisch sind, lassen sie sich nur in eine Richtung skalieren – vertikal. Dies schränkt die Agilität der Banken grundlegend ein, sowohl bei der Anpassung an Veränderungen als auch bei der Senkung der Kosten.
Glücklicherweise gibt es Hoffnung für die Banken. Wir haben es mit einem Problem zu tun, das in vielen Bereichen innerhalb und außerhalb der Finanzdienstleistungsbranche existiert und das durch eine Microservice-Architektur angegangen werden kann. In einer solchen Architektur kann jeder Teil des Systems dynamisch skaliert werden, wodurch sich die Anwendung elastisch an jede Verarbeitungsanforderung anpassen lässt. Gleichzeitig bleiben nicht betroffene Systemteile klein, was den gesamten Ressourcenbedarf (und damit die Kosten) niedrig hält. Eine Microservice-Architektur ebnet somit den Weg für ein skalierbares und echtzeitfähiges Kernbankensystem.
Warum führen die Anbieter der dritten Generation ihre bestehenden Systeme nicht einfach um, indem sie den Monolithen in eine Microservice-Architektur aufteilen?
Die Aufteilung des Kernbanken-Monolithen
Um diese Frage zu beantworten, lohnt ein Blick auf die wesentlichen Vorteile einer monolithischen Architektur. Ein Monolith verfügt über einen einzigen physischen Taktgeber und damit über einen einfachen Zugriff auf eine globale (totale) Reihenfolge. Eine solche totale Ordnung macht es relativ einfach, die Korrektheit jeder Anfrage sicherzustellen. Sobald der Monolith aufgeteilt wird, verlieren wir diesen gemeinsamen Takt und damit die Reihenfolge. Dies erschwert die Gewährleistung der Korrektheit erheblich. Die Anwendungslogik muss oft grundlegend überarbeitet werden, um Race Conditions und Engpässe durch Netzwerklatenz zu bewältigen. Ohne eine vollständige Neuentwicklung des Systems ist es oft kaum möglich, sicherzustellen, dass kausal zusammenhängende Ereignisse in der richtigen Reihenfolge verarbeitet werden, ohne den Systemdurchsatz massiv zu beeinträchtigen. Zudem besteht die Gefahr, in die Falle eines „verteilten Monolithen“ zu tappen und damit die schlimmsten Nachteile beider Welten zu vereinen.
Cloud-fähig vs. Cloud-nativ
Da die Systeme der dritten Generation Schwierigkeiten hatten, ihre Monolithen aufzubrechen, und der Marktdruck, „in die Cloud zu gehen“, zunahm, wählten viele Anbieter eine „Lift-and-Shift“-Strategie: Der monolithische Anwendungsserver wurde in einen Container verpackt und in der Cloud bereitgestellt. Auch wenn dies technisch als Cloud-Strategie durchgeht, ist sie kaum effektiv. Wir nutzen keinen der Vorteile der Cloud, insbesondere nicht die elastische Skalierbarkeit – wir haben es im Grunde immer noch mit demselben Monolithen zu tun, nur in einem teureren Rechenzentrum.
Vor diesem Hintergrund scheint die Zeit reif für eine neue Welle: eine vierte Generation von Kernbankensystemen, die von Grund auf so konzipiert sind, dass sie die elastische Skalierbarkeit der Cloud durch eine Microservice-Architektur voll ausschöpfen.
Warum ist das bisher nicht geschehen?
Es gibt eine Reihe von Gründen, warum wir erst jetzt den Beginn einer neuen Generation von Kernbankensystemen erleben:
- Banken agieren generell langsam. Ihre historisch bedingte Vorsicht ist angesichts der Kritikalität der verwalteten Daten verständlich. IT-Änderungen unterliegen meist strengen Governance-Prozessen zur Risikominderung, was jedoch den unbeabsichtigten Nebeneffekt hat, dass Prozesse verlangsamt werden.
- Ein effektives Entwicklungsökosystem und die entsprechende Kultur wachsen oft über Jahre organisch. Banken stehen daher vor einem Dilemma: Wichtige Kompetenzen wie COBOL verschwinden vom Markt, und der Aufbau eines internen Teams für ein moderneres Entwicklungsökosystem ist ein langfristiges Unterfangen.
- Bis vor Kurzem genoss die Cloud bei Regulierungsbehörden wenig Vertrauen, was Banken daran hinderte, Cloud-Infrastrukturen zu nutzen, um die Eintrittsbarrieren für skalierbare Systeme zu senken.
Wir sind jedoch der Meinung, dass ein wesentlicher Grund schlicht darin liegt, dass der Aufbau einer Bank in einer verteilten Umgebung eine komplexe Herausforderung darstellt.
Bei einer Microservice-Architektur arbeiten wir zwangsläufig in einer verteilten Umgebung. Das bedeutet, wir müssen mit einer breiten Palette an Latenzen umgehen: Ein Prozess innerhalb des Systems verbringt die meiste Zeit mit der Netzwerkkommunikation zwischen den Diensten. Wie Gregg (2013) veranschaulicht: Würde ein CPU-Zyklus eine Sekunde dauern, entspräche ein Netzwerk-Hop von San Francisco nach New York vier Jahren. Zudem sind wir den „Trugschlüssen des verteilten Rechnens“ ausgeliefert. Da wir, wie bereits erwähnt, keinen gemeinsamen Taktgeber haben, müssen wir uns auf ein unzuverlässiges Netzwerk einstellen, in dem Anfragen verzögert oder vollständig verloren gehen können.
In vielen anderen Branchen mag es akzeptabel sein, wenn eine Nachricht verloren geht oder gelegentlich eine Race Condition auftritt. Im Bankwesen hat die Korrektheit jedoch oberste Priorität. Wir dürfen keine einzige Nachricht verlieren, da dies von einer fehlerhaften Kontensynchronisation bis hin zum Verlust großer Geldsummen führen kann.
Da die Gewährleistung der Korrektheit in einem verteilten System eine schwierige Aufgabe ist, stellt die Entwicklung eines auf Microservices basierenden Kernbankensystems eine große Herausforderung dar.
Wie sieht also die „vierte Generation“ von Kernbankensystemen aus?
Die nächste Generation von Kernbankensystemen muss von Grund auf mit einem Cloud-First-Ansatz entwickelt werden. Elastische Skalierbarkeit muss fest integriert sein. Mechanismen zur Gewährleistung der Korrektheit müssen fest integriert sein. Eine extrem flexible Konfigurierbarkeit muss fest integriert sein. Diese Systeme müssen in der Lage sein, sowohl bei massivem Durchsatz zu skalieren als auch bei geringer Auslastung mit minimalem Ressourcenbedarf zu laufen. Diese Systeme müssen in Echtzeit arbeiten, es darf keinen Datenverlust und keine geplanten Ausfallzeiten geben, und das Wichtigste: Der Kern darf niemals abgeschaltet werden.
Der „Headless Core“
Darauf aufbauend ist es wichtig, dass die nächste Generation von Bankensystemen konservativ dimensioniert ist. Bei Mainframe-Systemen führt das „Aushöhlen“ des Kerns dazu, dass sie zu unflexibel werden. Systeme der dritten Generation leiden darunter, dass sie zu eng mit ihren Schnittstellen verknüpft sind, was sie zu einer Blackbox macht und Änderungen erschwert. Ein aufkommender Begriff, den Banken zur Beschreibung ihrer Transformationsanforderungen verwenden, ist der „Headless Core“.
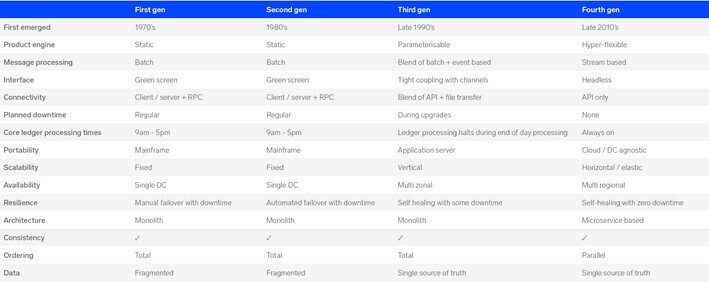
Um zu veranschaulichen, wie ein System der vierten Generation aussehen sollte, werfen wir einen Blick auf einige typische Fähigkeiten der Systeme der vorherigen Generation:
Warum also jetzt?
Cloud- und Microservice-Architekturen waren bis vor Kurzem noch „hochmodern“. Dies ändert sich rapide, da diese Technologien ausgereift sind und zum Standard werden. Cloud-Anbieter arbeiten heute eng mit Regulierungsbehörden zusammen und investieren massiv in ihre Infrastruktur, während die Netzwerke schneller und zuverlässiger werden. Viele Banken haben bereits produktive Systeme in Cloud-Umgebungen implementiert. Organisationen, die den Mainframe-Bereich dominieren, erkennen dies, wie IBMs kürzliche Ankündigung der „weltweit ersten für Finanzdienstleistungen bereiten Public Cloud“ zeigt. Es entstehen Tools und Frameworks, die die einst theoretische Seite des verteilten Rechnens in die gängige Praxis überführen, wie etwa Kubernetes, Istio und Kafka. Darauf aufbauend bedeutet die wachsende Popularität von NewSQL-Datenbanken wie Google Spanner und CockroachDB, die im Allgemeinen auf Quorum-basierter Konsistenz beruhen, sodass Schreibvorgänge an jeden Knoten gerichtet werden können, dass die Datenbank nun mit der Anwendung skalieren kann. Dies ebnet den Weg für eine echte lineare Skalierbarkeit. Das kumulative Ergebnis ist, dass wir uns zweifellos am Wendepunkt der aufkommenden vierten Generation von Kernbankensystemen befinden, die die Bedürfnisse von der kleinsten Gemeinschaftsbank bis zur größten globalen Tier-1-Bank abdeckt.
Vault Core – eine Kernbankenplattform der vierten Generation
Als wir bei Thought Machine unsere Reise begannen, um Vault Corezu entwickeln, erkannten wir sowohl die Herausforderung als auch die Chance. Wir haben ein System von Grund auf sorgfältig so konzipiert, dass es effizient in einer verteilten Umgebung arbeiten kann, ohne die Korrektheit zu opfern oder den Kern jemals abschalten zu müssen. Um dies zu erreichen, war uns klar, dass es entscheidend ist, dass wir als eine auf Technik und Produkt fokussierte Organisation starten und bleiben.
Wir haben Vault Core so konzipiert, dass es einen hohen Durchsatz bei angemessenen Latenzzeiten bewältigt und gleichzeitig einen Datenverlust ausschließt. Die richtige Balance zwischen den Systemeigenschaften zu finden, ist der Schlüssel – wie jeder Ingenieur für verteilte Systeme bestätigen wird, ist es ein Spiel der Kompromisse. Jede Designentscheidung wägt eine Reihe wichtiger Systemattribute ab, darunter Durchsatz, Latenz, Verfügbarkeit und Dauerhaftigkeit – die Gesetze der Physik lehren uns, dass man nicht alles haben kann. Vault wählt sorgfältig die richtigen Kompromisse an den richtigen Stellen.
Dies schließt den ersten Beitrag dieser Serie ab. Im Anschluss werden wir uns auf eine Reihe technischer Deep Dives zu einigen der Architekturmuster konzentrieren, die wir für den Aufbau von Vault Core verwendet haben. Wir werden untersuchen, wie das System als Ganzes als „ganzheitlich konsistent“ betrachtet werden kann, da wir uns auf Eventual Consistency stützen, wo immer es möglich ist, und bei Bedarf für starke Konsistenz sorgen. Wir werden untersuchen, wie wir das System skalierbar machen, indem wir auf etablierte Muster wie Shared-Nothing-Architektur, asynchrone/ereignisbasierte Verarbeitung und selektives Backpressure setzen. Wir werden untersuchen, wie die Korrektheit durch Ansätze wie At-least-once-Delivery mit Idempotenz, Ressourcen-Bitemporalität und optimistischem Locking gewahrt wird. Im nächsten Blogbeitrag dieser Serie werden wir uns damit befassen, wie wir Vektorkuhren und optimistisches Locking nutzen, um unsere Kern-Transaktionsverarbeitungspipeline zu skalieren.
———
Erfahren Sie jetzt mehr über Vault Core.
Referenzen:
Bericht zum Wachstum des digitalen Bankwesens, CACI: https://pages.caci.co.uk/rs/752-EBZ-498/images/caci-future-growth-digital-banking-report-2019.pdf
Gregg, Brendan. 2013: Systems Performance: Enterprise and the Cloud
IBM Financial Services Cloud: https://newsroom.ibm.com/2019-11-06-IBM-Developing-Worlds-First-Financial-Services-Ready-Public-Cloud-Bank-of-America-Joins-as-First-Collaborator